Gregor Ziegltrum und Dennis Schulz fragten mehr als hundert Unternehmen nach einer Kopie ihrer Daten – eine Möglichkeit, die die Datenschutzgrundverordnung (DSGVO) explizit einräumt. Sie wollten herausfinden: Was wissen die Unternehmen eigentlich über mich? Jeweils mehr als 6.000 Dateien bekamen die beiden zurück – und haben sie fleißig ausgewertet.
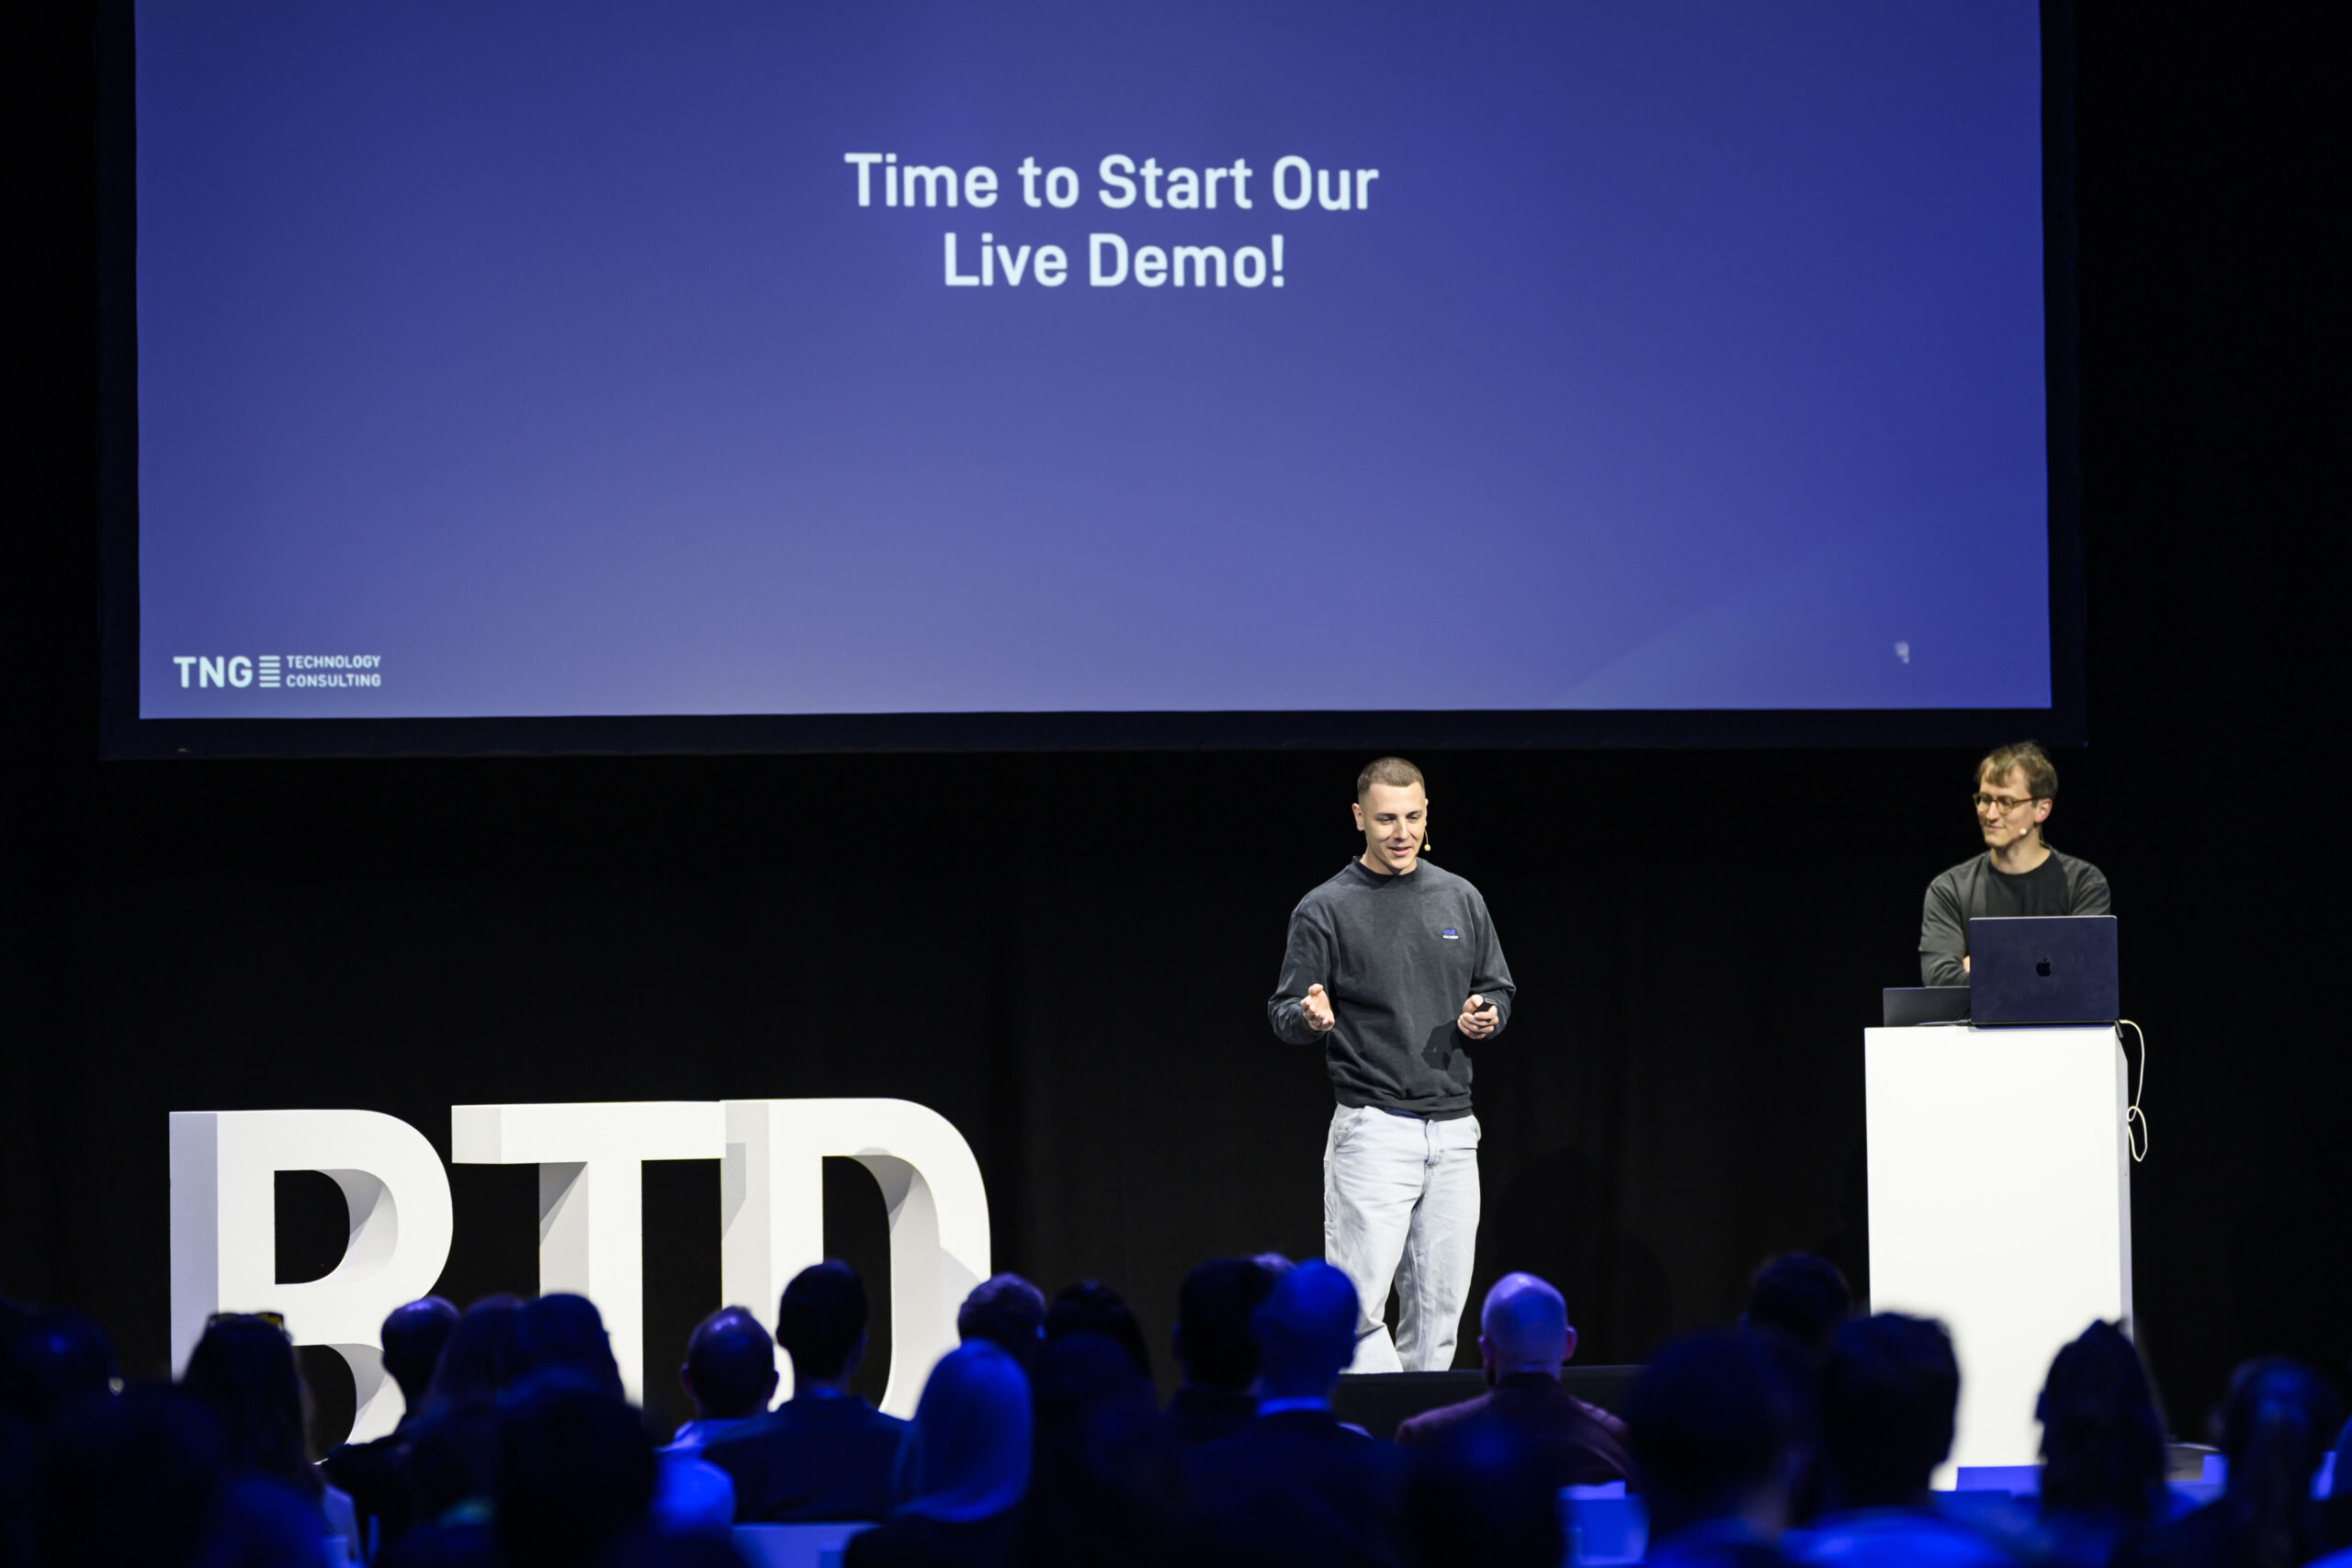
Herausgekommen ist ein Vortrag, den die beiden Softwareentwickler auf dem jährlichen Kongress ihrer Firma, TNG Technology Consulting, gehalten haben sowie auf den Datenspuren 2026. Dabei zeichnen sie mithilfe von Social-Media-Daten nach, wie sich ihre Interessen im Laufe der Zeit verändert haben und wie sich der eigene Tagesverlauf mit den verschiedenen Datenquellen rekonstruieren lässt.
Im Interview mit netzpolitik.org erzählen Schulze und Ziegltrum, wie einfach der Weg zu den eigenen Daten war, welche Hindernisse es gab und was sie aus ihrem Selbstexperiment gelernt haben. Außerdem geben sie Tipps, was man beim Nachmachen beachten sollte.
netzpolitik.org: Hallo Dennis, hallo Gregor. Ihr habt über 100 Unternehmen nach euren Daten gefragt. Wie seid Ihr auf diese Idee gekommen?
Gregor Ziegltrum: Wir haben uns beide unabhängig voneinander mit Spotify-Daten beschäftigt. Dennis hat daraus mit einem anderen Kollegen auch schon einen Vortrag gebaut. Und dann haben wir darüber nachgedacht, wie man das noch weiterspinnen kann.
Dennis Schulz: Mein Gefühl ist, dass viele sich schonmal gedacht haben: Meine Güte, man müsste doch mal diese ganzen Daten nehmen und gucken, was man daraus lernen kann. Aber dann macht man es nie.
„Wir sind einmal den Passwort-Manager durchgegangen“
netzpolitik.org: Welche Unternehmen habt Ihr angefragt?
Gregor Ziegltrum: Im Prinzip sind wir einmal den Passwort-Manager durchgegangen. Wir haben die großen Unternehmen angefragt: Meta, Spotify, LinkedIn, Reddit und alle Google-Services wie etwa YouTube. Aber auch Taxi-Apps wie Uber, Bolt und FreeNow.
Dennis Schulz: Wir haben auch unsere Banken angefragt und unsere Krankenkassen. Am Ende waren es fast 150 Stellen. Manche davon haben wir beide angefragt, manche nur einer von uns. Ich habe zum Beispiel noch die Deutsche Rentenversicherung und das Bundeskriminalamt angefragt. Dann auch eher kleinere Apps wie etwa „Trait“, die benutze ich zum Joggen. Da war ich offenbar der erste, der jemals nach Daten gefragt hat.
netzpolitik.org: Was habt ihr vorher noch nicht über euch gewusst?
Dennis Schulz: In den Daten steht drin, wie viele TikTok-Videos ich zu Ende geguckt haben. Das war schockierend und ist eine absolute Bestätigung, dass ich die App wieder gelöscht habe. Und in meinen Krankenkassendaten stand noch ein Nasenbeinbruch, den ich nie hatte. Ich habe inzwischen aber eine Vermutung, wo der herkommt.
Wie manche Unternehmen bei der Herausgabe tricksen
netzpolitik.org: Wie schwer war es, an die Daten heranzukommen?
Dennis Schulz: Extrem einfach. Ich finde, die meisten Unternehmen waren grundsätzlich relativ auskunftsfreudig und kooperativ. Das Nervige ist eher, dass man jedes Mal die E‑Mail-Adresse herausfinden muss, an die man die Anfrage schicken muss, oder den Service, mit dem man kommunizieren muss.
Es kommt aber vor, dass Unternehmen einen durch das Design ihrer Seite oder App dazu bringen wollen, nicht alle Daten anzufragen. Da gibt es dann zum Beispiel mehrere Optionen und wenn man die Option „Kompletter Datensatz“ wählt, kommt ein Warnhinweis: „Achtung! Da sind auch Log-Daten dabei, die nicht besonders nützlich sind, und es kann viel länger dauern, die zusammenzustellen. Möchtest du nicht lieber den kleinen Datensatz?“
Gregor Ziegltrum: Manchmal schicken Unternehmen bei der ersten Anfrage auch nur die Log-Daten der letzten 30 Tage, dann muss man noch mal nachfragen und dranbleiben.
Unternehmen ohne etablierte Prozesse fragen auch ganz oft, was man genau haben möchte. Mit der Aussage „alles“ kommen sie meistens nicht so gut klar, dann bekommt man manchmal nur die Stammdaten wie die Adresse. Hier lohnt es sich, in den Dialog zu gehen.
netzpolitik.org: Das heißt, es ist möglich, dass Unternehmen noch mehr Daten haben, die ihr aber nicht abgefragt habt, weil ihr euch gar nicht vorstellen konntet, dass das Unternehmen die hat?
Gregor Ziegltrum: Vielleicht. Aber ich meinte gar nicht, dass die Firmen die Daten bösartig zurückhalten, sondern dass man in den Austausch gehen muss, damit man genau das bekommt, was man möchte. Also vor allem bei kleinen Firmen, wo das nicht voll automatisiert ist.
Dennis Schulz: Alle großen Firmen haben riesige Datenpakete geschickt. Und zum Beispiel bei Spotify bin ich auch ziemlich sicher, dass da wirklich alles drin ist, was die haben. Wir können es natürlich nicht überprüfen. Aber alles in allem sind das sehr umfassende Datensätze, wo auch Daten drin stehen, bei denen die sich vielleicht mal kurz gefragt haben: „Müssen wir das wirklich mitschicken?“
„Sorry for the inconvenience“
netzpolitik.org: Haben Euch Unternehmen Eure eigenen Daten verweigert?
Gregor Ziegltrum: Ja, das war beispielweise der Fall, wenn Unternehmen die Daten im Auftrag von anderen Firmen verarbeiten. Für solche „Auftragsverarbeiter“ und „Unterauftragsverarbeiter“ gilt das Auskunftsrecht der DSGVO nicht. Man kann beispielsweise nicht zu einer Kreditkartenfirma wie Visa oder Mastercard direkt gehen und alle Transaktionen anfragen. Das muss man entweder bei der eigenen Bank abfragen oder bei den Online-Shops, bei denen man bezahlt hat.
Dennis Schulz: Es gibt ein amerikanisches Start-up, von dem wir explizit eine E‑Mail bekommen haben, dass sie Datenherausgabe derzeit nicht als Service anbieten und dass sie extrem „sorry for the inconvenience“ sind. Das habe ich dann beim Datenschutzbeauftragten gemeldet. Aber da habe ich nichts mehr von gehört.
Gregor Ziegltrum: Ich hatte dasselbe auch bei einer Firma aus der Schweiz, mit deren App ich für meine Führerscheinprüfung gelernt hatte. Das ist allerdings schon länger her. Da habe ich eine Löschanfrage gestellt und sie haben gesagt: „Ne, das machen wir nicht.“ Obwohl sie mir freudig in der EU dieses Produkt verkauft haben, wollten sie nicht der DSGVO-Löschanfrage nachgehen.
Dennis Schulz: Nach unseren Vorträgen kommen häufig Leute zu uns und meinen, dass die DSGVO eher ein stumpfes Schwert ist. Aber jetzt aus unserer Erfahrung würde ich dem nicht so zustimmen. Ich weiß zwar nicht, ob dieses „stumpfe Schwert“ geschwungen wirklich so furchtbar ist. Aber zumindest haben die Unternehmen genug Angst, dass die meisten die Daten rausrücken.
netzpolitik.org: Ihr habt zusammen über 12.000 Dateien zurückbekommen, insgesamt fast fünf Gigabyte. Wie habt Ihr das alles ausgewertet?
Gregor Ziegltrum: Sobald ich einen neuen Datensatz bekommen habe, habe ich erst mal ein bisschen rumgeschaut. Ganz viele Firmen geben dir HTML-Darstellungen, bei denen du durch deine Daten durchklicken kannst und erfährst, was das zu bedeuten hat. Da kriegt man ein bisschen ein Gefühl dafür, wo interessante Sachen liegen oder was langweiliger ist.
Danach habe ich mit einem KI-Tool weitergemacht. Ich habe der KI gesagt, „Hier sind die Daten. Sag mir mal, was könntest du denn Interessantes daran finden oder erklär mir mal die Unterordner.“ Dann kann man wie in einem Gespräch seine eigenen Daten tiefer anschauen. Außerdem konnte ich so die Daten schnell etwa von einem Format in ein anderes umwandeln, von HTML zu einer CSV-Datei zum Beispiel.
Dennis Schulz: Ich war ein bisschen manueller unterwegs und habe einfach erst mal nach großen Dateien und nach Dateien mit vielen Timestamps gesucht. Aber ja, auch ich habe die KI viel für die Umwandlung von Daten und Dateiformaten benutzt. Denn einer der frustrierendsten Punkte bei dieser ganzen Auswertung waren die vielen unterschiedlichen Arten, wie Daten formatiert sind. Beispiel Kalenderdatum: Da steht manchmal das Jahr ganz vorne, manchmal ganz hinten – und manchmal ist das angegeben in Millisekunden seit dem 1. Januar 1970.
netzpolitik.org: Wie habt Ihr sichergestellt, dass ihr die Daten jetzt nicht einfach einem KI-Unternehmen in den Rachen geworfen habt?
Gregor Ziegltrum: Am Ende habe ich meine Daten einem KI-Unternehmen in den Rachen geworfen. Aber ich habe mir vorher schon Gedanken gemacht, welche Datensätze ich da reinpacke und welche nicht. Meine Krankenkassen-Daten habe ich nicht da reingetan. Außerdem lief das bei mir über einen Anbieter, mit dem mein Arbeitgeber einen Vertrag hat, in dem auch das Training mit diesen Daten ausgeschlossen ist. Ich hätte das wahrscheinlich nicht mit einer kostenlosen Version von ChatGPT gemacht.
Trotzdem würde ich im Nachhinein mehr mit Trusted-KI-Hosting-Lösungen arbeiten, bei denen explizit kein KI-Unternehmen dahinter steht und wo vielleicht ein Open-Source-Modell gehostet worden ist.
Wenn TikTok die Uber-Fahrt trackt
netzpolitik.org: Von den angefragten Unternehmen: Welche App oder Firma wusste das meiste über Euch?
Alles netzpolitisch Relevante
Drei Mal pro Woche als Newsletter in deiner Inbox.
Dennis Schulz: Facebook.
Gregor Ziegltrum: Bei mir war es YouTube.
Dennis Schulz: Facebook hat sich für mich am krassesten angefühlt, einfach weil das mein Leben vor 15 Jahren bis vor 10 Jahren ist. Da habe ich das intensiv genutzt und da stand am meisten drin, was ich jetzt peinlich finde. Weil man generell peinlich findet, was man vor 10 bis 15 Jahren gemacht hat.
Gregor Ziegltrum: Und für mich waren es ganz klar Google und YouTube, weil ich Facebook irgendwann nicht mehr benutzt habe. Mit meinem YouTube-Account bin ich seit 2012 unterwegs und da hat sich halt eben auch echt einiges angesammelt. Eine Slide unseres Vortrags hatte den Titel „Going Down Memory Lane“. Genauso habe ich mich gefühlt, als ich nach meinem ersten YouTube-Kommentar geschaut habe.
netzpolitik.org: Was hatten die für Daten von Euch?
Gregor Ziegltrum: Google im Generellen hat echt viele Services und dadurch auch viele Daten. Ich habe Google Cloud und Google Photos benutzt. Das heißt, die haben erst mal alle meine Fotos, die ich auf dem Handy habe. Die haben viele Cloud-Daten von mir. Die haben alle Kommentare, die ich auf YouTube geschrieben habe. Die haben meine Suchhistorie und meine Verlaufshistorie über Google Chrome. Die haben alle Spiele und Videos, die ich irgendwie bei Google Play gekauft habe. Weil ich YouTube Music verwende, haben die auch meine ganzen Musik-Playlists. Alle meine Kontakte. Und meine Kalendereinträge.
Dennis Schulz: Bei Facebook sind es wirklich hunderte Dateien, in denen alle möglichen unterschiedlichen Logs drin stehen. Was mich tatsächlich überrascht hat: Die Facebook-App speichert immer wieder, wie viel freier Speicherplatz noch auf dem Handy ist. Facebook speichert auch die IP-Adresse, die das Handy gerade hat und es steht auch ein Ort in den Daten, den sie aus dieser IP herleiten. Was mich aber am meisten angefasst hat, waren meine alten Chatverläufe: Dass alte Beiträge noch da sind, dass Kommentare noch da sind. Und dass noch gespeichert ist, wenn ich auf Werbung geklickt habe, wenn ich ein Event angeguckt habe.
Krass fand ich auch, dass alle größeren Firmen „Off-App-Activities“ gespeichert hatten. Da steht dann plötzlich zum Beispiel in den TikTok-Daten, dass man Spotify geöffnet hat oder eine Fahrt mit einem Uber abgeschlossen hat. Ich weiß nicht mal genau, wie diese Daten da hinkommen.
Gregor Ziegltrum: Eine Sache, die mich ein bisschen schockiert hat, war Uber. Die speichern nämlich für die „App Analytics“ Koordinaten, nicht nur für die Fahrten. Da steht dann, dass ich zu einer bestimmten Uhrzeit eine „Impression“ bekommen habe, und das war dann an dem Längen- und dem Breitengrad. Leider erklärt Uber nicht weiter, was diese Impressions genau sind. Ich denke es handelt sich um eine Push-Benachrichtigung im Zusammenhang mit einer Fahrt, oder dass ich die App geöffnet hatte.
Selbst im eigenen Datenschatz wühlen
netzpolitik.org: Habt Ihr euer Online-Verhalten nach der Recherche verändert?
Gregor Ziegltrum: Ich habe an vielen Stellen personalisierte Werbung ausgeschaltet. Ich möchte ja eigentlich am liebsten gar keine Werbung. Und wenn ich Werbung möchte, dann möchte ich eigentlich schlechte Werbung, damit ich da eh nicht draufklicke.
Dennis Schulz: Mir ist klar geworden, wie viel Zeit ich auf Sozialen Medien verbracht habe und dann habe ich die Apps alle vom Handy gelöscht. Jedes Mal, wenn ich jetzt irgendwo anklicke, dass meine Daten verwendet werden, überlege ich mir, ob ich das wirklich will. Andererseits möchte ich noch mehr finden für unser Projekt, das ist ein komischer Anreiz. Bei meinem aktuellen Auto habe ich die zugehörige App verbunden, auch ein bisschen, um in ein paar Monaten eine Anfrage zu schicken und mal zu schauen, was da passiert. Gregor hat zum Beispiel überlegt, ob er sich jetzt vielleicht die RewePlus-App anschaffen soll, damit er gucken kann, was die für Daten speichern.
netzpolitik.org: Was gebt Ihr anderen Menschen mit, die sich selbst mal durch den eigenen „Datenschatz“ wühlen wollen?
Gregor Ziegltrum: Lasst euch nicht mit der ersten E‑Mail und dem ersten Datensatz von einem Unternehmen abspeisen! Wenn ihr denkt, da ist noch mehr: Einfach noch mal nachfragen. Und je konkreter die Anfrage ist, desto konkretere Antworten bekommt man.
Dennis Schulz: Es ist cool, das zu machen. Man bekommt die Kontrolle über die Daten nicht zurück, aber man bekommt ein Gefühl dafür, was es heißt, dass diese Daten von einem im Netz bzw. bei irgendwelchen Unternehmen sind. Diese Daten sind ja eine Erweiterung der eigenen Person ins Internet hinein. Darüber zumindest ein Verständnis zu haben, ist extrem hilfreich, um sich in dieser Welt zu bewegen.

Schreibe eine Ergänzung!